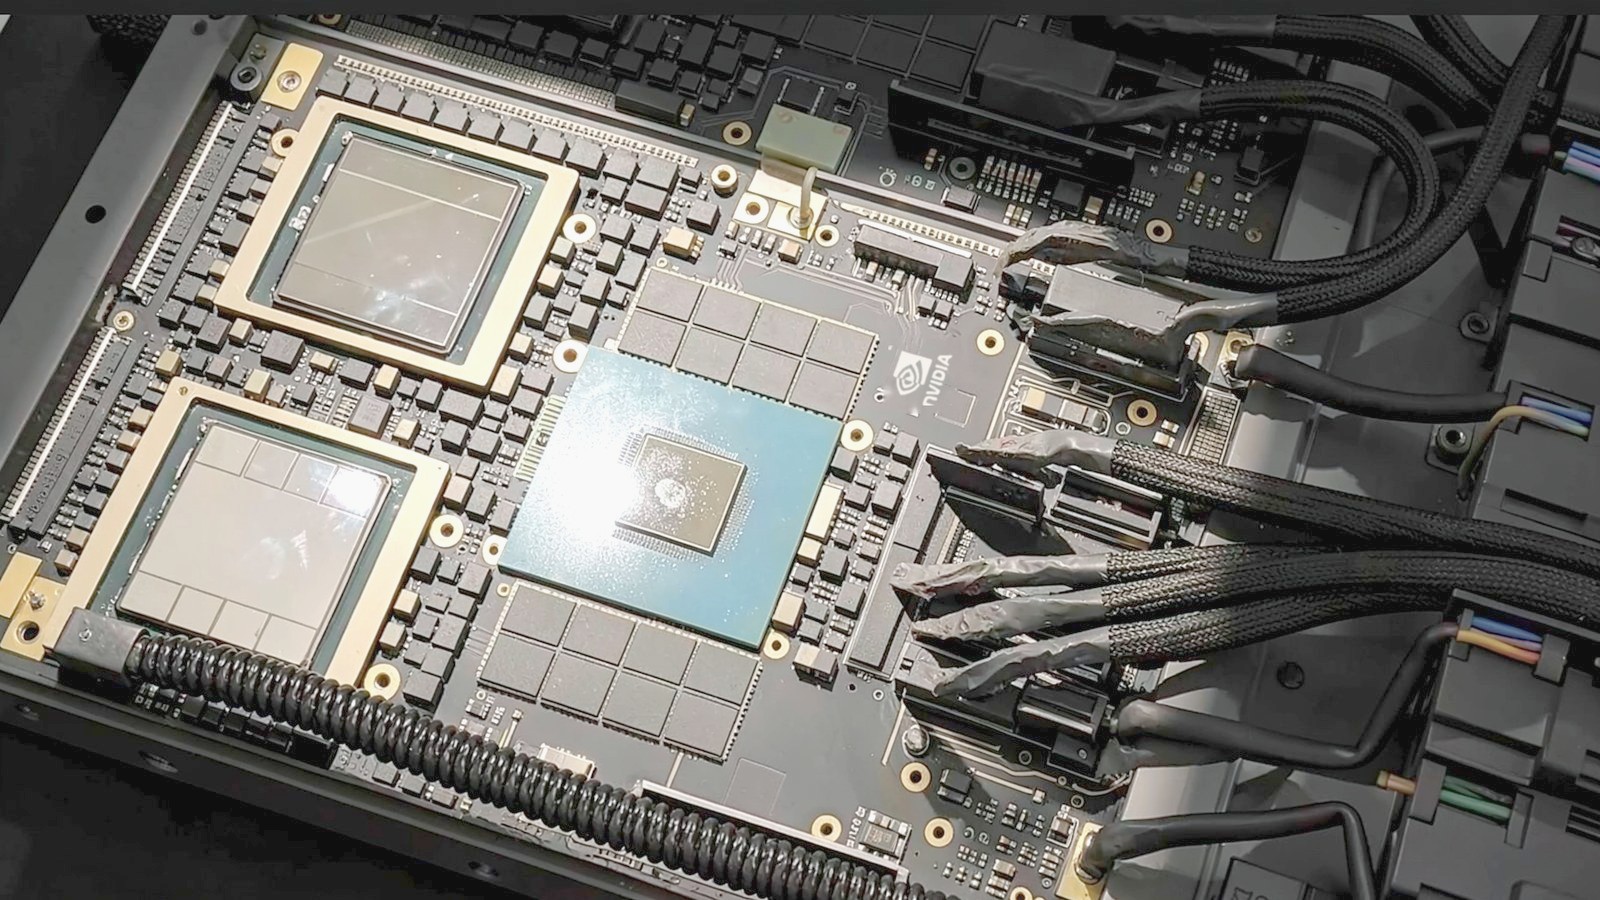
Nvidia nació en 1993 con tres ingenieros y una idea para mejorar los gráficos de los videojuegos. Hoy sus chips entrenan y hacen funcionar casi toda la inteligencia artificial del mundo, corrigen la imagen de los telescopios, filtran las colisiones de partículas del CERN y enseñan a andar a robots en mundos virtuales. Esta es la tecnología que hay detrás del nombre, explicada con palabras sencillas: qué hace una GPU, todo el ecosistema de Nvidia, la ciencia que impulsa, las fábricas que simula y lo que viene después.
Por qué importa: cuando haces una pregunta a un chatbot, generas una imagen o consultas el pronóstico del tiempo, el cálculo pesado suele hacerse en algún equipo de Nvidia. Y esta semana la empresa ha cambiado de líder por primera vez en 33 años (lo contamos en El TSUNAMI de NVIDIA). El fundador se ha ido; la tecnología que explicamos aquí es lo que se queda.
Qué hace de verdad una GPU
Un procesador normal, la CPU, es como un gran cocinero que prepara un plato tras otro. Una GPU (unidad de procesamiento gráfico) es como una cocina con miles de cocineros que hacen a la vez una tarea sencilla cada uno. Eso es perfecto para dibujar millones de píxeles en un videojuego, y resultó perfecto también para la IA, porque entrenar un modelo de IA consiste sobre todo en repetir miles de millones de veces la misma multiplicación. (Nuestra guía de la CPU, la GPU, la NPU y la TPU explica toda la familia de chips).
Las GPU actuales para centros de datos son gigantes. Blackwell, presentada en marzo de 2024, reúne 208.000 millones de transistores en dos piezas de silicio unidas por un enlace de 10 terabytes por segundo, con 192 GB de memoria HBM3e muy rápida (Nvidia; Tom’s Hardware). También estrenó FP4, una forma de hacer los cálculos de IA con números de solo 4 bits: menos precisa en cada paso, pero mucho más rápida y barata, y suficiente para casi todo el trabajo de IA. La nueva GPU Rubin va más allá: 336.000 millones de transistores, 288 GB de memoria HBM4 que mueve 22 terabytes por segundo y conexiones NVLink 6 de 3,6 terabytes por segundo con sus vecinas (Nvidia; SiliconANGLE).
La clave no es un chip, sino muchos chips que trabajan como uno solo. Un armario Vera Rubin NVL72 une 72 GPU Rubin y 36 CPU Vera (de 88 núcleos cada una) de forma tan estrecha que el software ve una única máquina gigante con 20,7 TB de memoria HBM4, según las especificaciones preliminares de Nvidia.
Todo el ecosistema de Nvidia
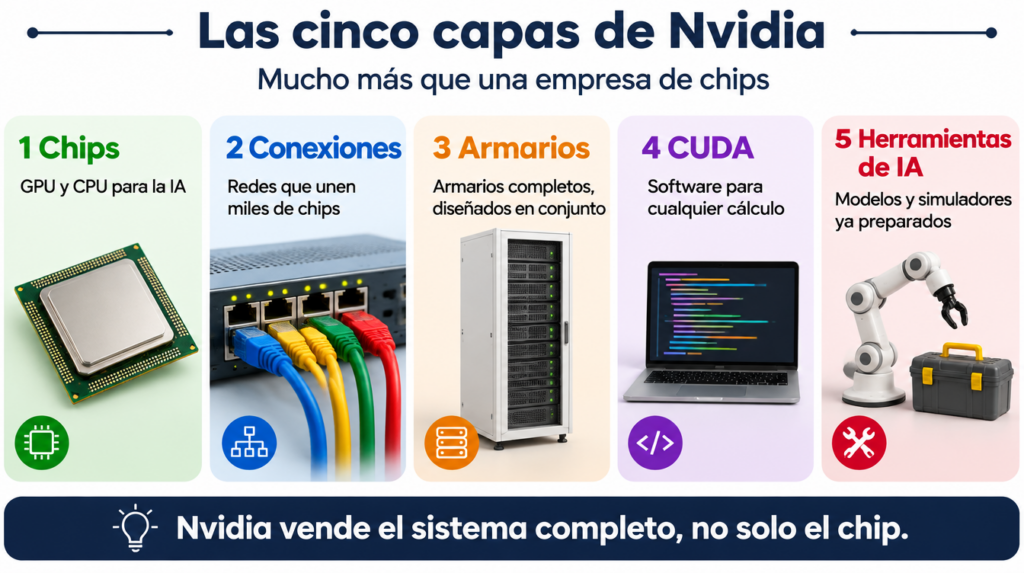
Nvidia dejó de ser «solo una empresa de chips» hace mucho. Su verdadero producto es un conjunto de capas que encajan entre sí, y muy pocos rivales ofrecen todas:
- Chips: GPU para centros de datos (Blackwell, Rubin), sus propias CPU Arm (Grace, Vera), GeForce RTX para jugadores y creadores y RTX PRO para estaciones de trabajo.
- Conexiones: NVLink entre GPU, redes InfiniBand y Ethernet Spectrum-X y chips de red BlueField y ConnectX. Buena parte vino de Mellanox, que Nvidia acordó comprar en 2019 por unos 6.900 millones de dólares (registro ante la SEC; Data Center Frontier).
- Sistemas: armarios completos (NVL72), servidores DGX y pequeños ordenadores de IA de sobremesa como DGX Spark.
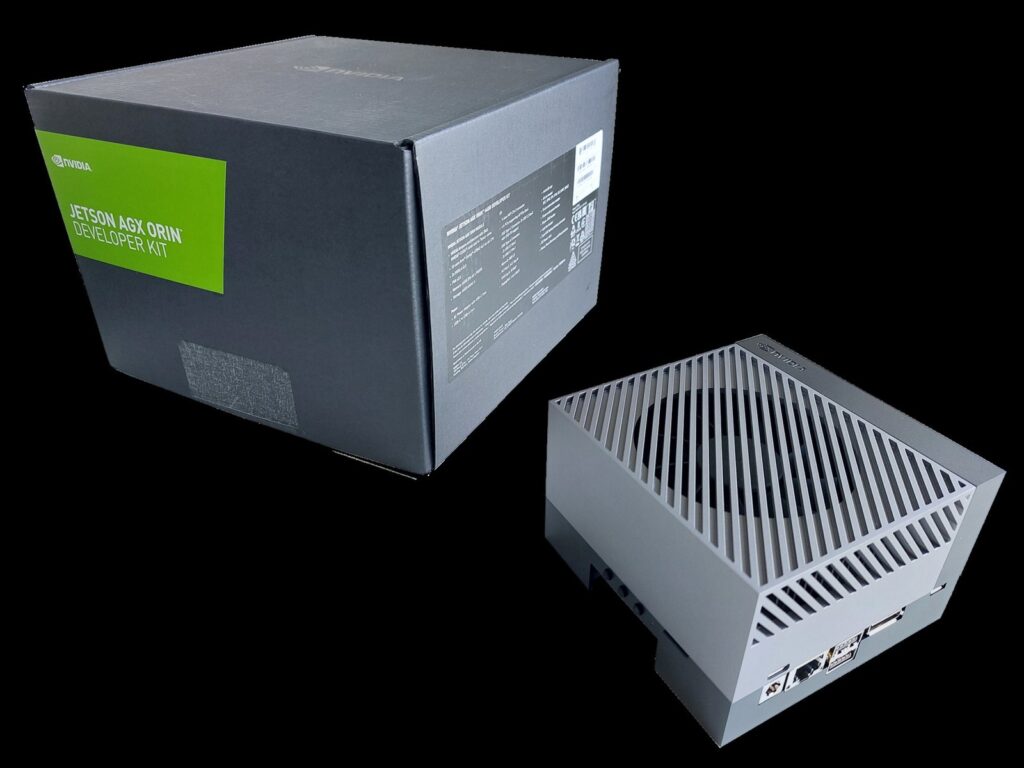
- Robots y dispositivos: los módulos Jetson, que ponen una GPU dentro de robots, drones y máquinas. El más nuevo, Jetson AGX Thor, salió a la venta en agosto de 2025 a 3.499 dólares el kit de desarrollo (TweakTown). DRIVE hace lo mismo en los coches.
- CUDA: el software que permite usar una GPU para cualquier cálculo. Se presentó en 2006, se publicó en 2007 y hoy tiene unos 6 millones de programadores, según Nvidia, además de bibliotecas como cuDNN para redes neuronales y cuBLAS para álgebra lineal.
- Plataformas: Omniverse para gemelos digitales en 3D, Isaac para robots, los «modelos del mundo» Cosmos, los servicios de IA listos para usar NIM y DLSS, que usa la IA para dibujar fotogramas extra en los juegos.
El dinero muestra dónde está el peso. En los tres meses hasta el 26 de julio de 2026, Nvidia ingresó 96.200 millones de dólares, y 89.000 millones vinieron de los centros de datos.
De la mesa de un restaurante a CUDA
Jensen Huang, Chris Malachowsky y Curtis Priem fundaron Nvidia el 5 de abril de 1993, tras darle forma a la idea entre comidas en un restaurante Denny’s de San José (cronología de Nvidia). El chip RIVA 128 de 1997 fue el primer éxito: en enero de 1998 Nvidia ya había enviado la unidad un millón. En 1999 llegó la GeForce 256, vendida como la primera GPU del mundo.
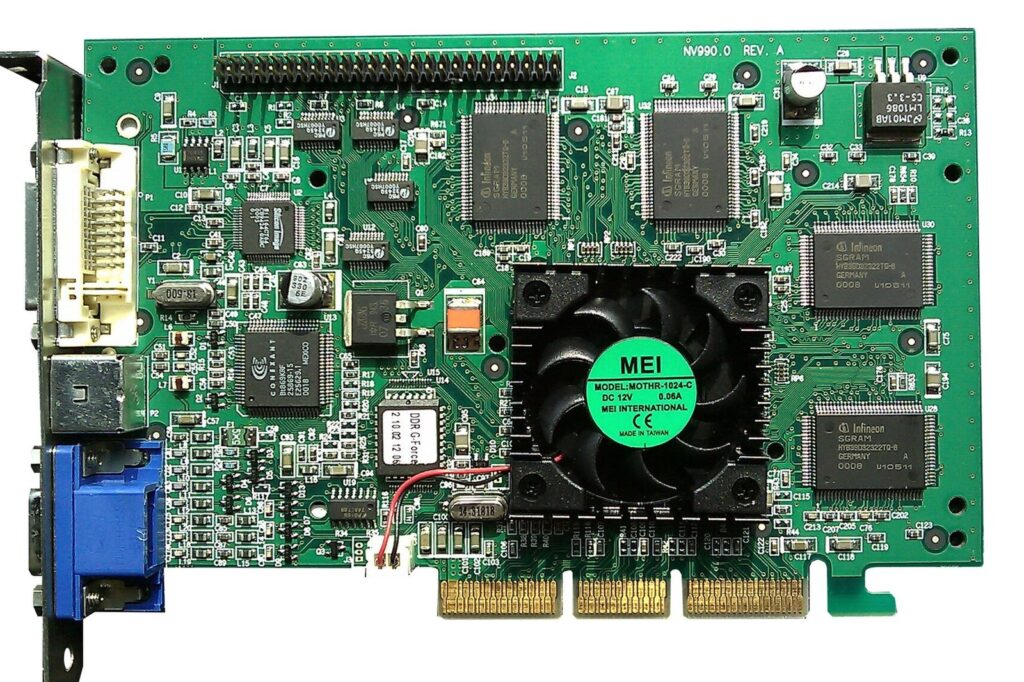
La apuesta que lo cambió todo fue CUDA. Al principio parecía un capricho caro. Hasta que en 2012 un equipo de la Universidad de Toronto entrenó una red de reconocimiento de imágenes llamada AlexNet con dos tarjetas de juego Nvidia GTX 580, durante cinco o seis días, y superó con mucha ventaja a todos sus rivales (el artículo original). Los investigadores se pasaron a las GPU, su código se escribió en CUDA, y esa costumbre sigue siendo la mayor ventaja de Nvidia.
GPU para la ciencia: de los telescopios al CERN
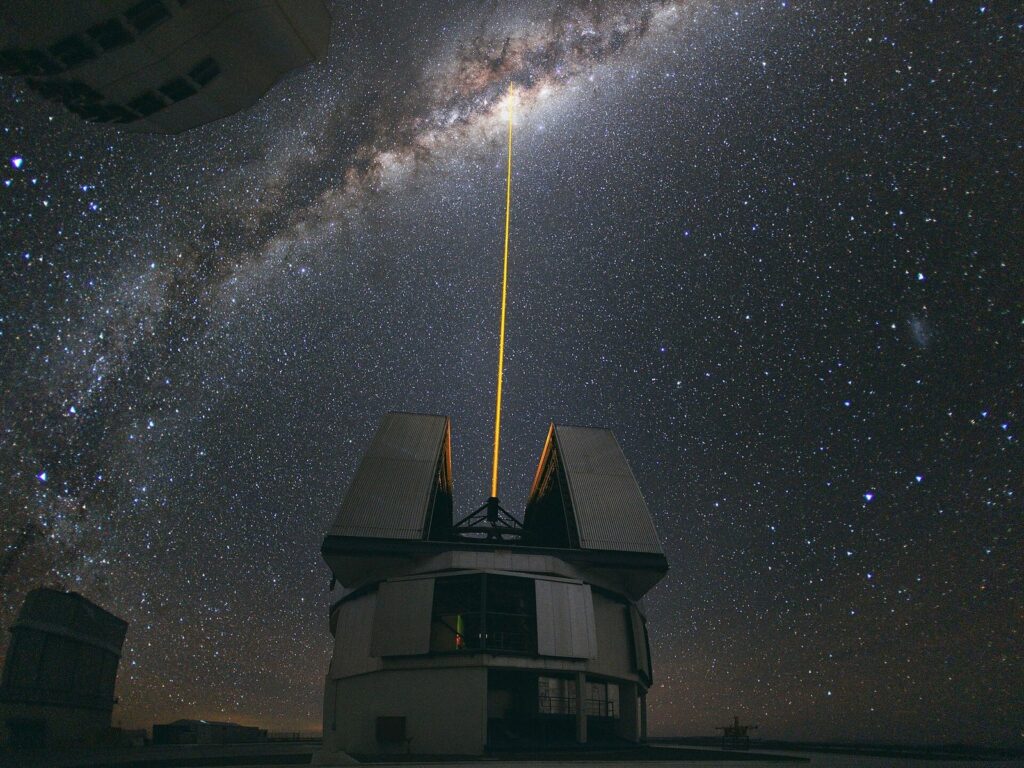
Telescopios más nítidos con óptica adaptativa. El aire de la Tierra se mueve y tiembla, por eso titilan las estrellas, y eso emborrona la imagen de cualquier gran telescopio. La óptica adaptativa lo corrige: un sensor mide la distorsión, a menudo con una estrella artificial creada por un láser que apunta al cielo, y un espejo flexible se deforma para anularla, cientos o miles de veces por segundo. Lo difícil es el cálculo intermedio, que hay que hacer en una fracción de milisegundo. Hoy ese trabajo lo hace una GPU. En el Observatorio Keck de Hawái, un nuevo controlador en tiempo real basado en GPU de Nvidia debe cerrar el ciclo de la cámara al espejo en 500 microsegundos como máximo, con el objetivo de bajar a 250 (equipo de Keck, SPIE 2022; ANU). Se basa en COSMIC, una plataforma de GPU del Observatorio de París y la Universidad Nacional de Australia que funcionó en el cielo con unos 110 microsegundos de retraso. La misma plataforma está prevista para MAVIS, un nuevo instrumento del Very Large Telescope de ESO en Chile, con un objetivo de 160 microsegundos (taller de ESO; SPIE 2024).
Física de partículas. En el CERN, el primer filtro del experimento LHCb, llamado Allen, funciona solo con GPU: unas 500 criban 30 millones de colisiones de partículas por segundo hasta quedarse con el millón o dos que merece la pena guardar (Computing and Software for Big Science; CERN). El experimento ALICE también reconstruye sus datos con GPU.
Clima y tiempo. En noviembre de 2025, un equipo europeo con participación de Nvidia ganó el premio Gordon Bell de modelización climática al ejecutar un modelo completo del sistema Tierra con una resolución de 1,25 km en unos 8.000 chips Grace Hopper del superordenador suizo Alps (idw; DKRZ). La plataforma Earth-2 de Nvidia usa la IA para convertir pronósticos de 25 km en detalle de 2 km; Nvidia asegura que es 1.000 veces más rápida que los métodos tradicionales (Nvidia; The Register). Lo contamos en la IA mejora el pronóstico hasta un mes antes.
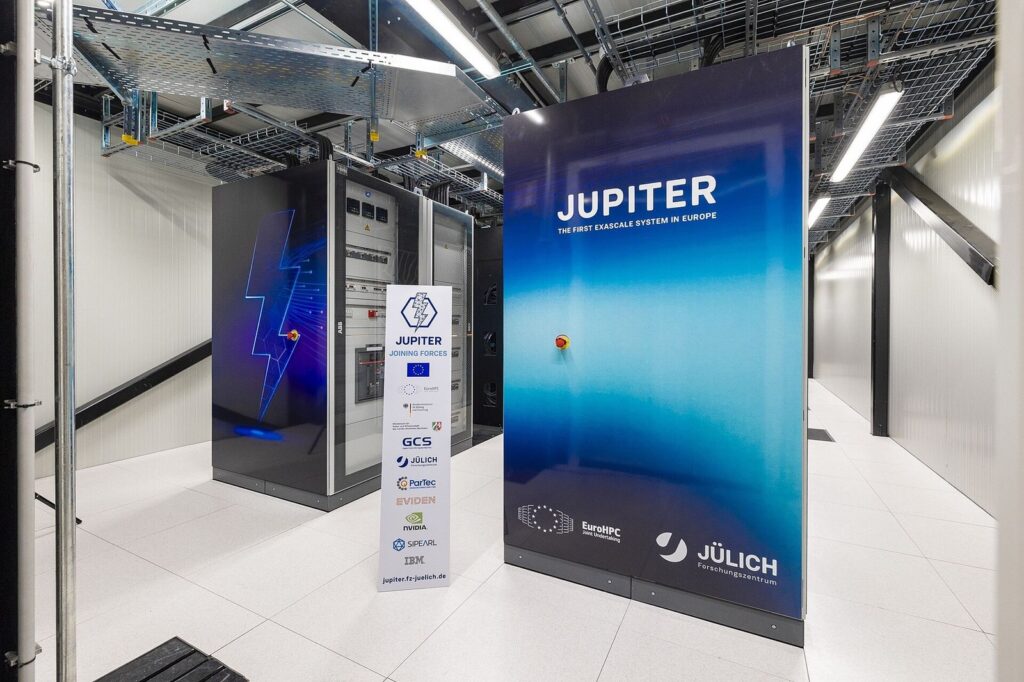
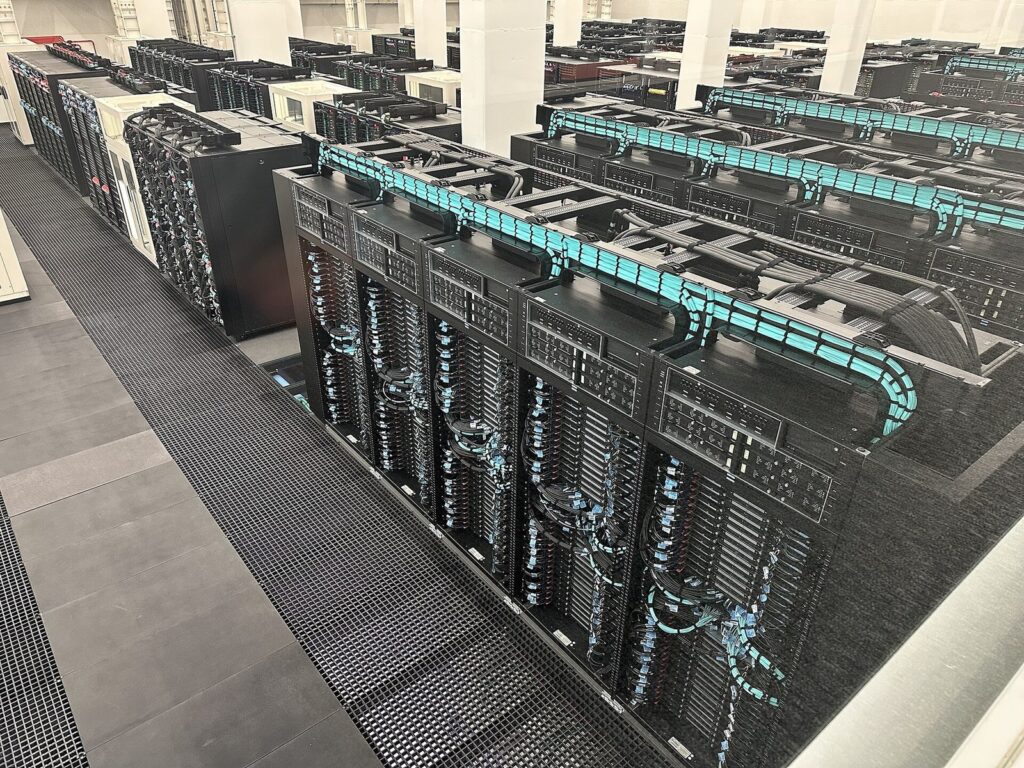
Superordenadores. La primera máquina exaescala de Europa, JUPITER, en Jülich (Alemania), usa unos 24.000 superchips Nvidia GH200 Grace Hopper y alcanzó justo un exaflop, un trillón de cálculos por segundo, en la clasificación TOP500 (EuroHPC; TOP500). En Barcelona, la parte acelerada del MareNostrum 5 funciona con más de 4.400 GPU Nvidia H100 (TOP500; BSC). No todas las grandes máquinas son de Nvidia: El Capitan, en EE. UU., usa AMD, y el número uno actual, el chino LineShine, no usa GPU.
Medicina y cuántica. BioNeMo, la plataforma abierta de Nvidia para descubrir fármacos con IA, la usan más de 200 empresas de biotecnología y farmacia, según Nvidia, y CUDA-Q permite simular ordenadores cuánticos en GPU antes de que los reales sean lo bastante grandes (Nvidia; The Quantum Insider).
La familia RTX: una arquitectura, de los juegos al PC de IA
La serie GeForce RTX 50, lanzada desde enero de 2025 sobre la misma arquitectura Blackwell, es la parte de Nvidia que casi cualquiera puede comprar. Cada tarjeta tiene núcleos CUDA para los gráficos, núcleos RT para la luz realista y núcleos Tensor para la IA, que mueven DLSS 4: por cada fotograma que dibuja la tarjeta, la IA puede generar hasta tres más (Nvidia). Esos mismos núcleos Tensor ejecutan modelos de IA en casa, sin la nube.
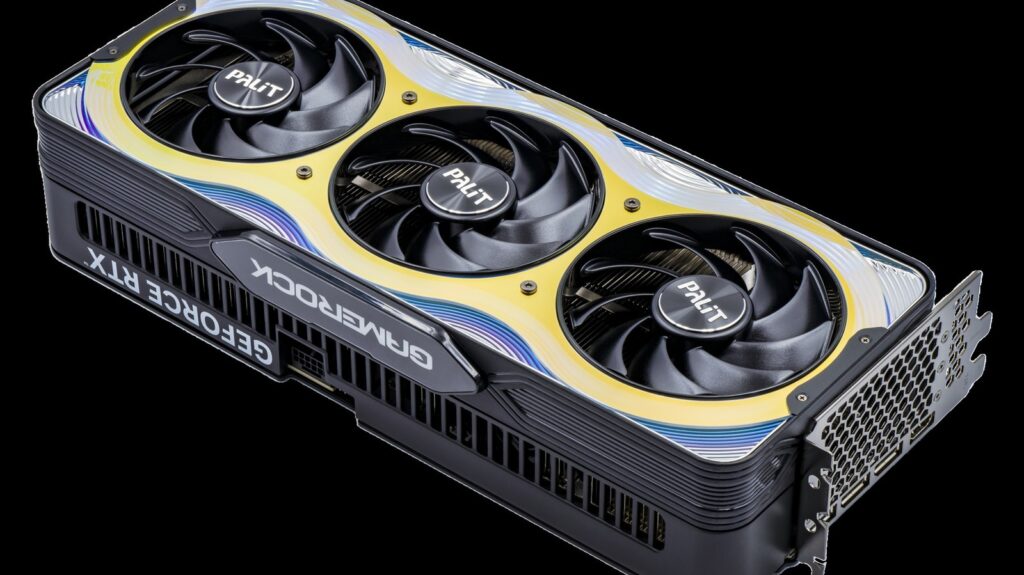
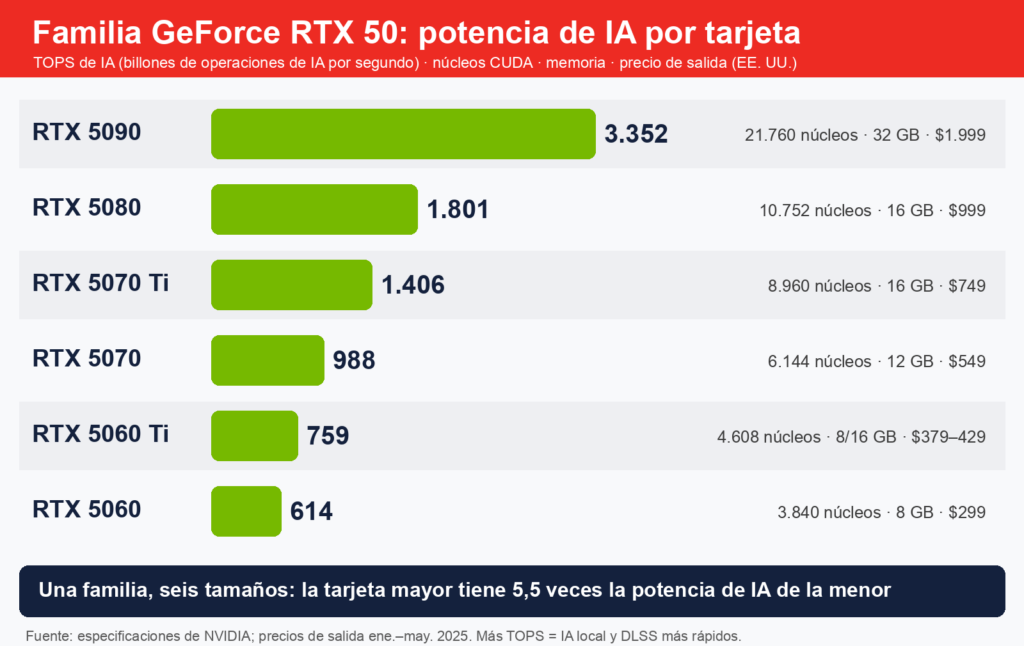
Las cifras salen de las especificaciones de Nvidia, y los precios de salida los confirman GamersNexus y Tom’s Hardware. Los «TOPS de IA» son billones de operaciones de IA por segundo (lo explicamos en ¿Qué son los TOPS de IA?). Para profesionales, la RTX PRO 6000 Blackwell tiene 24.064 núcleos CUDA y 96 GB de memoria (StorageReview).
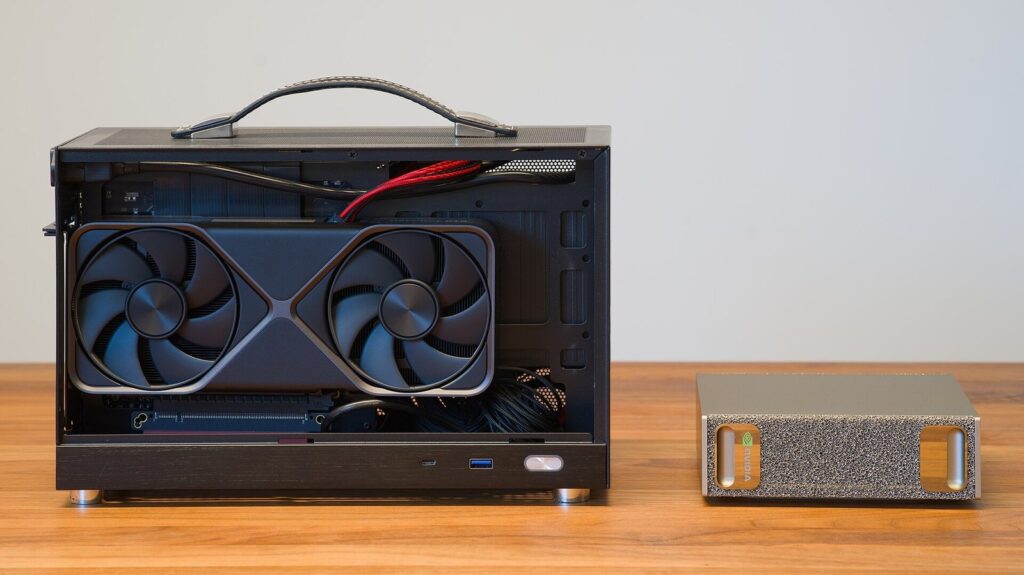
Los ordenadores más nuevos. DGX Spark, una caja dorada del tamaño de un libro, salió a la venta el 15 de octubre de 2025 a 3.999 dólares con el chip GB10 de Nvidia, 128 GB de memoria compartida y hasta un petaflop de potencia de IA en FP4 (Engadget; The Register); desde entonces su precio ha subido (ServeTheHome). Su hermano mayor, DGX Station, ofrece 748 GB de memoria. Y desde el 16 de octubre de 2026 la misma idea cabe en un portátil: los portátiles RTX Spark de ASUS, Dell, HP, Lenovo, Microsoft y MSI.
Agentes de IA en casa: del Mac mini a NemoClaw
El éxito sorpresa de la IA personal este año ha sido OpenClaw, un agente de código abierto que trabaja en tu ordenador por ti: responde mensajes, ordena archivos y hace tareas. Mucha gente lo instaló en un Mac mini de Apple, lo que provocó una ola de compras a principios de 2026 (Business Insider; Decrypt). La respuesta de Nvidia llegó en su conferencia GTC del 16 de marzo de 2026: NemoClaw, un paquete que instala OpenClaw con los modelos Nemotron de Nvidia y un entorno aislado de protección, para usarlo en PC con RTX y en ordenadores DGX (Nvidia; SiliconANGLE). «OpenClaw es el sistema operativo de la IA personal», dijo Huang. La idea para Nvidia es sencilla: un agente que funciona en casa necesita una GPU en casa.
Los robots aprenden en mundos virtuales
Enseñar a un robot a base de prueba y error en el mundo real es lento y rompe cosas. Por eso los robots practican primero en simulación: miles de copias virtuales, cada una en un suelo ligeramente distinto, que se caen sin peligro millones de veces hasta aprender. Se llama aprendizaje por refuerzo, y lo difícil es el salto del mundo virtual ordenado al real, desordenado, la llamada «brecha entre simulación y realidad». Las herramientas gratuitas Isaac Sim e Isaac Lab de Nvidia hacen la práctica; Cosmos, lanzado en enero de 2025, añade «modelos del mundo» entrenados con 20 millones de horas de vídeo que pueden generar escenas de práctica realistas (TechCrunch).
En marzo de 2025, un pequeño droide al estilo de Star Wars llamado Blue salió al escenario con Jensen Huang, y Nvidia, Google DeepMind y Disney Research anunciaron Newton, un motor de física abierto para entrenar robots (TechCrunch; TechRadar). Los droides BDX de Disney, que ya pasean por sus parques, aprenden sus movimientos así.
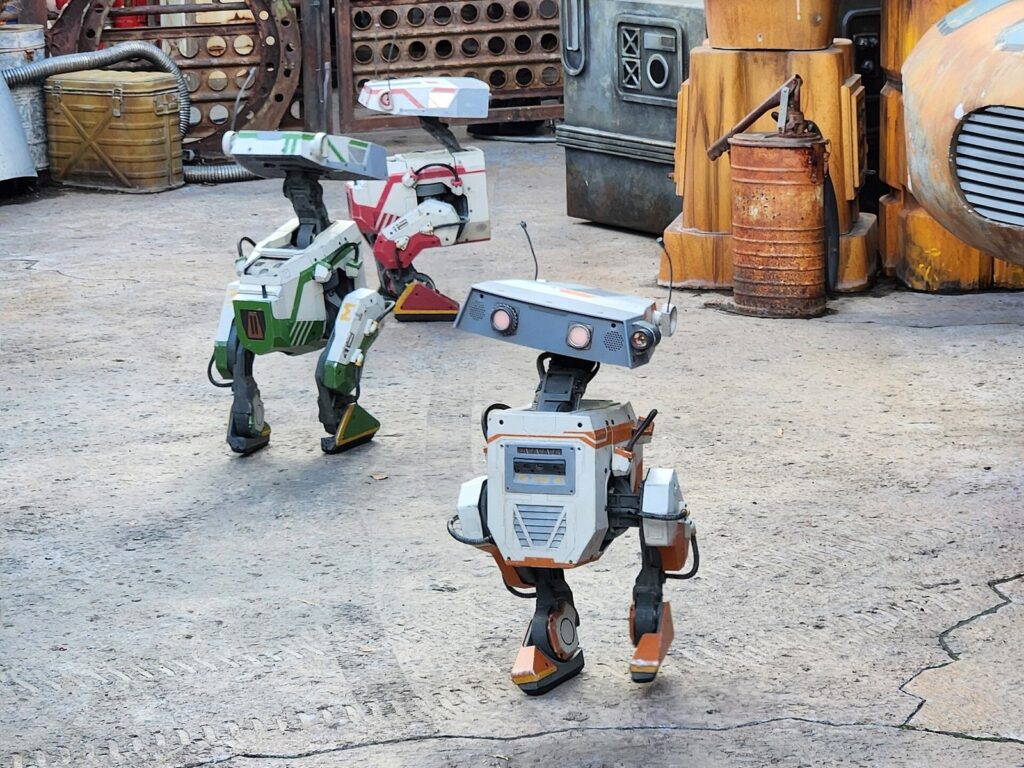
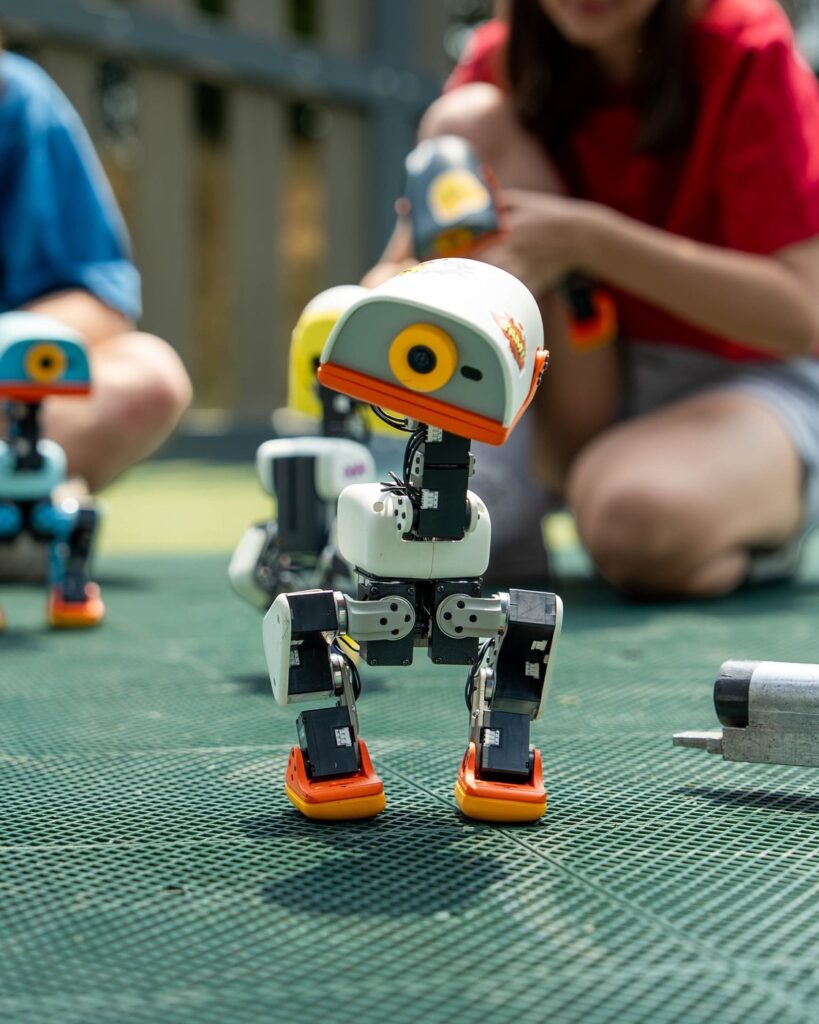
El ejemplo más simpático es el pato. En la conferencia de Nvidia en el GTC de Berlín, el 21 de octubre de 2026, cuatro robots Microduck de 25 centímetros, de Pollen Robotics y Hugging Face, se sentaron, se echaron la siesta y dieron volteretas cuando se lo pidieron. Cada uno aprendió a andar en simulación: el tutorial de Nvidia ejecuta 4.096 patos virtuales a la vez en una sola tarjeta gráfica, hasta 1,25 millones de pasos de simulación por segundo, con una física desordenada a propósito para que el pato real se apañe en un suelo real (Hugging Face y Nvidia; The Register). Lo explicamos paso a paso en así aprende a andar el pato robot, y la misma idea en un robot humanoide que aprende a andar y manipular.
Fábricas digitales: primero se construye en virtual
Las mismas herramientas de simulación planifican ya fábricas enteras. BMW planificó su nueva planta de Debrecen (Hungría) por completo en Nvidia Omniverse: un «gemelo digital» de la fábrica funcionó en producción virtual más de dos años antes de que abriera la real, construido a partir de más de 7 millones de metros cuadrados de edificios de BMW escaneados en 3D (BMW Group; BMW Blog). BMW usa ya su Virtual Factory en más de 30 centros y calcula que reducirá los costes de planificación hasta un 30 % (Assembly Magazine). Foxconn y TSMC planifican sus fábricas igual (Nvidia).
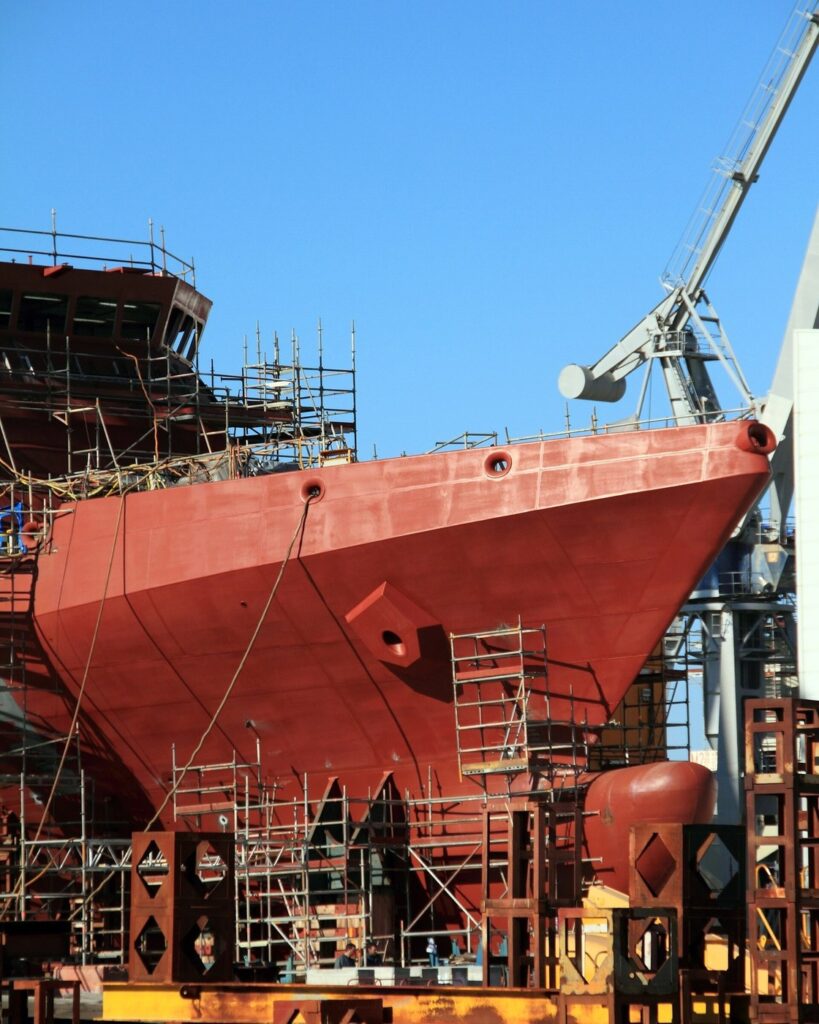
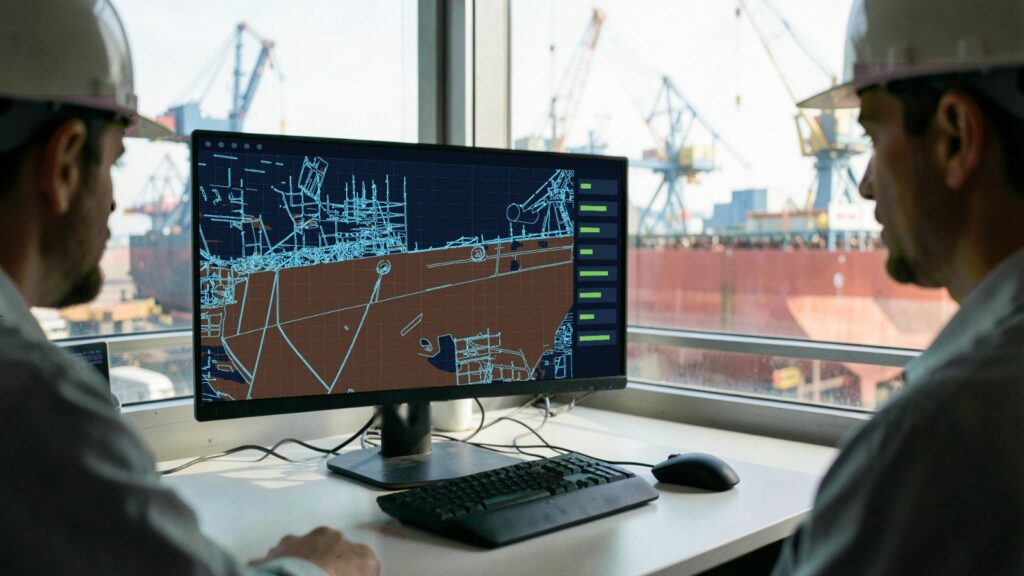
La construcción naval va en la misma dirección. La española Navantia construye un astillero digital, el «Astillero 4.0», y diseña sus fragatas F-110 en torno a un gemelo digital, aunque con otros socios: Accenture y el software Xcelerator de Siemens, con un centro mixto de investigación en Ferrol que apunta al «Astillero 5.0» (Accenture; Digital Engineering; Universidade da Coruña). La idea es la misma en todas partes: probar cada robot, grúa y línea de producción en el mundo virtual y construir una sola vez. Hasta la propia física se aprende así, como en una IA que simula arena, agua y telas.
La hoja de ruta: una generación nueva cada año
Nvidia sacaba una familia de chips nueva cada dos años. Ahora lo hace cada año, y publica el plan por adelantado para que los clientes preparen edificios y suministro eléctrico.
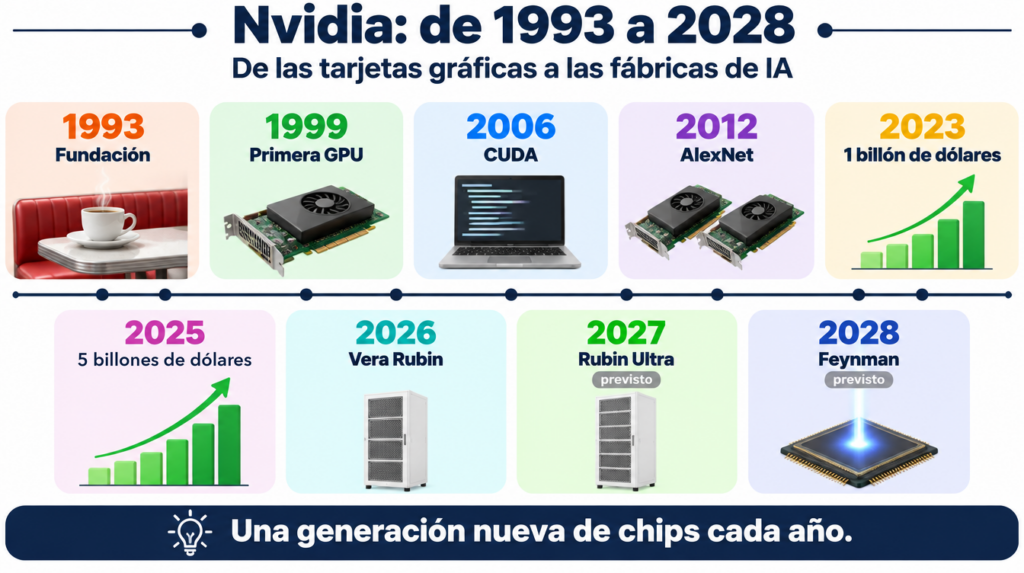
2025: Blackwell Ultra. 288 GB de memoria por GPU y alrededor de 1,5 veces la potencia de IA de Blackwell (Tom’s Hardware).
2026: Vera Rubin. Su nombre honra a la astrónoma que encontró las pruebas de la materia oscura. No es un chip, sino una familia diseñada en conjunto: la GPU Rubin, la CPU Vera de 88 núcleos, los conmutadores NVLink 6, los chips de red ConnectX-9 y BlueField-4 y los conmutadores Spectrum-6 con óptica de luz integrada. Nvidia dijo en agosto que Vera Rubin estaba en plena producción y ya funcionaba en varias empresas de la nube (Nvidia; ASUS).
2027: Rubin Ultra. Cuatro chips de GPU en un mismo encapsulado y 1 TB de memoria HBM4E, en un nuevo armario «Kyber» en el que los ordenadores se colocan en vertical, como libros en una estantería. Un solo armario podría consumir hasta 600 kilovatios, así que sacar el calor es tan difícil como hacer los chips (mira el líquido que hierve dentro del chip).
2028: Feynman. En honor al físico Richard Feynman, con chips apilados unos sobre otros, una nueva CPU llamada Rosa, por Rosalind Franklin, y más conexiones que usan luz en lugar de cobre (The Next Platform; HPCwire), una idea que explicamos en mover datos con luz en lugar de cables.
Claves
- Una GPU son miles de pequeñas calculadoras trabajando a la vez, justo lo que necesitan la IA, los gráficos y la ciencia.
- Nvidia vende un ecosistema completo: chips, redes, armarios, CUDA y plataformas listas para robots, fábricas y ciencia.
- Las GPU ya mueven los espejos de los telescopios en microsegundos, filtran las colisiones del CERN y hacen funcionar el primer superordenador exaescala de Europa.
- Robots y fábricas se construyen cada vez más dos veces: primero en un mundo virtual y después en el real.
- El plan es una generación nueva al año: Vera Rubin (2026), Rubin Ultra (2027) y Feynman (2028).
Qué pasa ahora
Hay tres cosas que merece la pena seguir. La primera, los resultados de hoy, 17 de noviembre, los primeros con la consejera delegada interina. La segunda, si se mantiene el ritmo de una generación de chips al año mientras crece Vera Rubin. La tercera, la energía: cada paso de la hoja de ruta necesita más electricidad por armario, así que el límite de la IA pronto podría ser el enchufe y no el chip.
Sigue leyendo
- El TSUNAMI de NVIDIA
- Pato robot Microduck: así aprende a andar en un mundo virtual
- Cómo se iluminó el universo tras el Big Bang: simulación Lumina
Lo mejor de la semana en tecnología, gratis
Un email a la semana con las noticias que importan, explicadas fácil. Sin spam.
Fuentes
- NVIDIA Announces Financial Results for Second Quarter Fiscal 2027, NVIDIA Newsroom, 26 de agosto de 2026
- NVIDIA Blackwell Platform Arrives to Power a New Era of Computing, NVIDIA Newsroom, 18 de marzo de 2024
- Blackwell B200 GPU revealed, Tom’s Hardware, marzo de 2024
- Inside the NVIDIA Rubin Platform, NVIDIA Technical Blog, enero de 2026
- Nvidia debuts Rubin chip, SiliconANGLE, 5 de enero de 2026
- NVIDIA Vera Rubin NVL72, NVIDIA product page, 2026
- Mellanox acquisition filing, Comisión de Bolsa y Valores de EE. UU. (SEC), 2020
- Nvidia to acquire Mellanox in $6.9 billion deal, Data Center Frontier, marzo de 2019
- Jetson AGX Thor dev kit, TweakTown, agosto de 2025
- Corporate timeline, NVIDIA
- ImageNet Classification with Deep Convolutional Neural Networks, Krizhevsky, Sutskever and Hinton, NeurIPS 2012
- Enabling the next generation of Keck AO with the RTC upgrade, Chin et al., SPIE 2022
- Keck AO real-time controller, Australian National University
- COSMIC and MAVIS real-time computers, ESO RTC4AO workshop, 2023
- MAVIS RTC: a COSMIC-based real-time computer, SPIE 2024
- Allen: a high-level trigger on GPUs for LHCb, Computing and Software for Big Science, 2020
- Allen documentation, CERN
- Gordon Bell Prize for Climate Modelling 2025, idw, noviembre de 2025
- ICON simulations nominated, DKRZ, 2025
- NVIDIA Announces Earth Climate Digital Twin, NVIDIA Newsroom, 18 de marzo de 2024
- Nvidia’s AI climate model takes aim at severe weather, The Register, 19 de agosto de 2024
- JUPITER: launching Europe’s exascale era, EuroHPC, 5 de septiembre de 2025
- TOP500 list, noviembre de 2026, TOP500
- MareNostrum 5 ACC, TOP500
- MareNostrum 5 overview, Barcelona Supercomputing Center
- NVIDIA expands CUDA-Q, NVIDIA Newsroom, 14 de septiembre de 2026
- Nvidia expands open-source CUDA-Q platform, The Quantum Insider, 14 de septiembre de 2026
- DLSS 4 Multi Frame Generation, NVIDIA, enero de 2025
- GeForce graphics cards compared, NVIDIA
- RTX 5090, 5080, 5070 Ti and 5070 specs, GamersNexus, enero de 2025
- RTX 5060 Ti and RTX 5060 announced, Tom’s Hardware, abril de 2025
- RTX PRO 6000 workstation GPU review, StorageReview
- Nvidia starts selling its $3,999 DGX Spark, Engadget, octubre de 2025
- Nvidia GB10 Spark, The Register, 13 de octubre de 2025
- NVIDIA DGX Spark 64GB launched and 128GB price increases, ServeTheHome, 3 de octubre de 2026
- The Mac mini’s moment, thanks to OpenClaw, Business Insider vía AOL, 2026
- OpenClaw and the Mac mini shortage, Decrypt, 2026
- NVIDIA Announces NemoClaw, NVIDIA Newsroom, 16 de marzo de 2026
- Nvidia launches NemoClaw agent toolkit, SiliconANGLE, 16 de marzo de 2026
- Nvidia releases its own brand of world models, TechCrunch, 6 de enero de 2025
- Nvidia partners with Google DeepMind and Disney, TechCrunch, marzo de 2025
- Nvidia, Google and Disney’s Star Wars robot, TechRadar, marzo de 2025
- Microduck: sim-to-real with Isaac Lab, Hugging Face and NVIDIA, 21 de octubre de 2026
- Jensen Huang sends in the robot ducks, The Register, 21 de octubre de 2026
- Virtual production under way in future plant Debrecen, BMW Group, 21 de marzo de 2023
- BMW is virtually planning its Neue Klasse factory with Nvidia, BMW Blog, 22 de marzo de 2023
- BMW scales Virtual Factory, Assembly Magazine, 11 de junio de 2025
- Omniverse digital twins for Taiwan’s manufacturers, NVIDIA Blog
- Accenture assists Navantia, Accenture, diciembre de 2019
- Navantia partners with Siemens to digitalize shipbuilding, Digital Engineering
- Digital twin research line, CEMI, University of A Coruña and Navantia
- Blackwell Ultra B300, Tom’s Hardware, marzo de 2025
- ASUS ramps up Vera Rubin NVL72 shipments, ASUS vía PR Newswire, noviembre de 2026
- Rubin Ultra with 600,000-watt Kyber racks, Tom’s Hardware, marzo de 2025
- Driving down the AI system roadmap with Nvidia, The Next Platform, 19 de marzo de 2026
- Huang shares Nvidia roadmap, HPCwire, 17 de marzo de 2026