Un equipo del KAIST, en Corea del Sur, ha creado una IA que lee los labios con menos fallos gracias a un truco que conoce cualquier aficionado a los crucigramas: primero se escriben las palabras seguras y luego se usan para resolver las difíciles. El sistema convierte en texto el vídeo sin sonido de la boca de una persona que habla, según informó la universidad el 13 de noviembre.
Por qué importa: que una máquina lea los labios puede ayudar a las personas sordas o con problemas de audición a seguir una conversación, y permitiría «hablar» con los aparatos en lugares donde el ruido de las máquinas tapa cualquier voz. El problema siempre ha sido la precisión. Este trabajo demuestra que basta con cambiar el orden en que la IA escribe su respuesta para mejorar el resultado.
Por qué cuesta tanto leer los labios
Prueba a decir «pata», «bata» y «mata» delante de un espejo. Tus labios hacen casi lo mismo las tres veces. Los sonidos /p/, /b/ y /m/ son prácticamente imposibles de distinguir solo con la vista, y el lenguaje hablado está lleno de parecidos como estos.
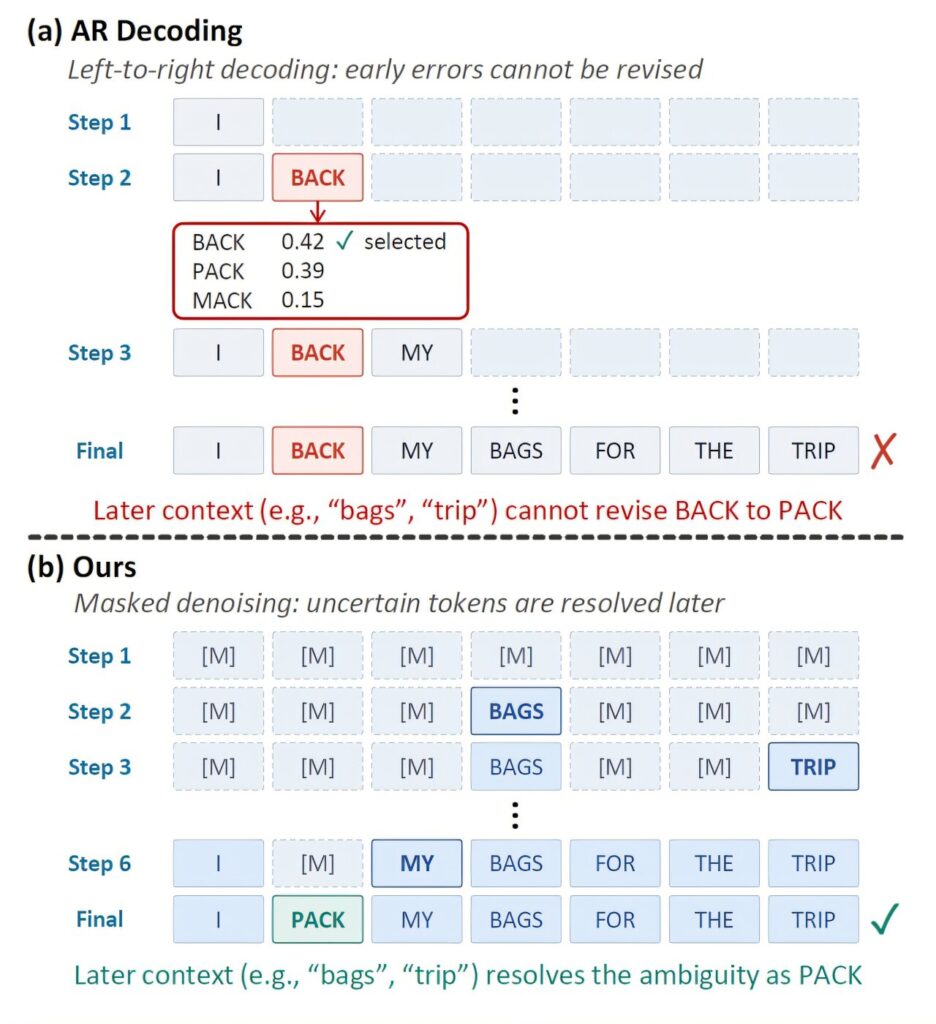
La mayoría de las IA de voz escriben una frase como nosotros en un papel: de izquierda a derecha, una palabra detrás de otra y sin volver atrás. Para leer labios, eso es arriesgado. Si la segunda palabra es un cara o cruz y la IA elige mal, el error se queda ahí y puede arrastrar a las palabras siguientes.
El ejemplo del propio equipo, en inglés, lo deja claro. La persona dice «I pack my bags for the trip» («Hago las maletas para el viaje»). Un modelo que va de izquierda a derecha llega a la segunda palabra, ve «back» (atrás) un poco más probable que «pack» (hacer la maleta), escribe «back» y sigue adelante. Cuando llegan «bags» (maletas) y «trip» (viaje), las palabras que habrían resuelto la duda, ya es tarde.
Primero lo seguro, las dudas después
El sistema del KAIST, llamado DLLM-VSR, trabaja de otra manera. Se basa en un modelo de lenguaje de difusión: una IA de lenguaje que empieza con una fila de huecos en blanco y los va rellenando en varias rondas, en el orden que quiera, en vez de escribir estrictamente de izquierda a derecha.
En cada ronda, el modelo solo da por buenas las palabras de las que está seguro. En el ejemplo, «bags» y «trip» entran pronto. Esas palabras sirven después de pista a ambos lados del hueco dudoso y, con unas maletas y un viaje en la frase, «pack» gana con facilidad. Según el artículo científico del equipo, las palabras seguras se fijan primero y luego se usan como contexto, por delante y por detrás, para afinar las ambiguas.
Queda un pequeño rompecabezas. Una fila de huecos necesita una longitud, y un vídeo sin sonido no dice cuántas palabras vienen. Así que el sistema usa la duración del vídeo para calcular varias longitudes de frase posibles, escribe una frase candidata para cada una y se queda con la que le parece más fiable.
¿Y qué tal lo hace?
El equipo probó el modelo con LRS3, un banco de pruebas habitual con 433 horas de vídeo etiquetado de personas hablando en inglés. Logró una tasa de error por palabra del 19,4 %: acierta más o menos cuatro de cada cinco palabras solo con el movimiento de los labios. Los autores lo presentan como el mejor resultado entre los métodos que usan únicamente LRS3 como datos etiquetados de entrenamiento. En la tabla comparativa del artículo, las IA parecidas entrenadas de la misma forma, sin pistas adicionales, rondan el 25 %.
Dos apuntes honestos. El primero: leer labios sigue lejos de ser perfecto, porque una de cada cinco palabras está mal. El segundo: el propio artículo cita un sistema entrenado con unas ocho veces más vídeo etiquetado que lo hace un poco mejor, con un 19,1 %. Lo llamativo del resultado del KAIST es que se acerca con muchos menos datos, no que gane a todos.
El trabajo se publicó como prepublicación en mayo y ha sido aceptado en EMNLP 2026, uno de los principales congresos sobre IA y lenguaje. El primer autor es el investigador posdoctoral Jeong Hun Yeo, junto a los doctorandos Chae Won Kim y Hyeongseop Rha, en el grupo del profesor Yong Man Ro, de la Escuela de Ingeniería Eléctrica del KAIST. El código es público.
Dónde puede ayudar
- Lugares de trabajo ruidosos: en una fábrica o junto a maquinaria pesada, un micrófono oye sobre todo ruido. Una cámara sí puede ver los labios.
- Accesibilidad: el texto en directo a partir de los labios podría ayudar a personas sordas o con problemas de audición.
- Robots y dispositivos que se llevan puestos: el equipo quiere máquinas que entiendan a las personas de forma fiable en el día a día y en entornos industriales.
La idea de «decidir primero lo seguro» aparece este año en más rincones de la IA. Hace poco te contamos el caso de los agentes de IA que solo piden ayuda cuando dudan y el de un robot que corrige su propia memoria. Saber lo que no sabes resulta ser una habilidad muy útil, también para las máquinas.
Qué viene ahora
El modelo todavía no está listo para tus gafas. Probar varias longitudes de frase cuesta más tiempo de cálculo, reconocen los autores, y por ahora solo se ha probado en inglés. El siguiente paso del equipo es hacerlo más pequeño y ligero para que funcione en tiempo real en robots y dispositivos que se llevan puestos, sin conexión a internet. Si sale bien, puede que el primer sitio donde te lo encuentres sea uno muy ruidoso.
Cursos de IA en Udemy en español, desde lo básico hasta crear tus propias aplicaciones, a tu ritmo.Ver cursos con descuento →Las mejores certificaciones de IA →
Sigue leyendo
- Agentes de IA que solo piden ayuda si dudan son 3 veces mejores
- Un robot IA confunde una chimenea con una ardilla y consigue corregir su propia memoria
- El sónar de tu reloj inteligente ya puede seguir todo tu cuerpo
Lo mejor de la semana en tecnología, gratis
Un email a la semana con las noticias que importan, explicadas fácil. Sin spam.
Fuentes
- Lip-reading AI fills gaps in sentences by recognizing most certain words first, KAIST vía Tech Xplore, 13 de noviembre de 2026
- Diffusion Large Language Models for Visual Speech Recognition, Yeo, Kim, Rha y Ro, prepublicación en arXiv, 27 de mayo de 2026 (revisada el 1 de septiembre de 2026)
- Diffusion Large Language Models for Visual Speech Recognition, actas de EMNLP 2026, ACL Anthology, octubre de 2026
Aviso: este artículo contiene enlaces de afiliado
Si compras a través de ellos, la empresa editora puede recibir una comisión sin coste adicional para ti. Nuestras recomendaciones se basan en especificaciones, precios y análisis publicados, no en pagos de ningún tipo.